
DeepSeek V4 发布后AI产业洞察:昇腾生态算力驱动行业Agent从“工程外挂”走向“全栈内生”
本报告将从当前大模型应用中对工程依赖的痛点出发,依次剖析昇腾CANN生态的技术支撑机制、垂直行业Agent在电力和财经场景下的建设逻辑,并展望AI基础设施、多模态与具身智能三大未来趋势。
**部分 回顾与反思——理想SOTA模型必须摆脱「工程依赖」
1.1 DeepSeek V4春节洞察回顾:工程脚手架的集体困境
2026年春节,笔者在DeepSeek V4洞察报告中指出:现有Agent工程技术本质上是在大模型外搭建脚手架。
这一判断已得到多项数据印证——AI生成代码中45%包含安全漏洞;CodeRabbit研究报告显示,AI生成代码中重大缺陷的发生率是人工编写代码的1.7倍。
1.2 DeepSeek V4前主流开源基座模型的四大先天缺陷
| 能力维度 | 先天缺陷 |
|---|---|
| 记忆与知识 | 模型权重在训练后冻结,知识存在硬性截止点。事实性幻觉顽固存在,模型无法精准区分自身知识边界,面对未知问题时倾向于“自信地编造”而非坦诚承认无知。 |
| 逻辑与规划 | 深度推理本质上仍依赖提示词模板驱动,而非真正的内生逻辑演绎。推理模型虽有所改善,却带来了显著的延迟瓶颈与上下文污染问题。 |
| 交互与感知 | 多数模型仍以“文本进、文本出”为核心范式,无法原生操作数字环境,复杂视觉推理能力明显不足。 |
| 上下文窗口 | 即便***Token上下文已成现实,“迷失在中间”效应依然制约着长文本处理精度,超长推理的计算成本高得难以普及。 |
1.3 「工程脚手架」的问题
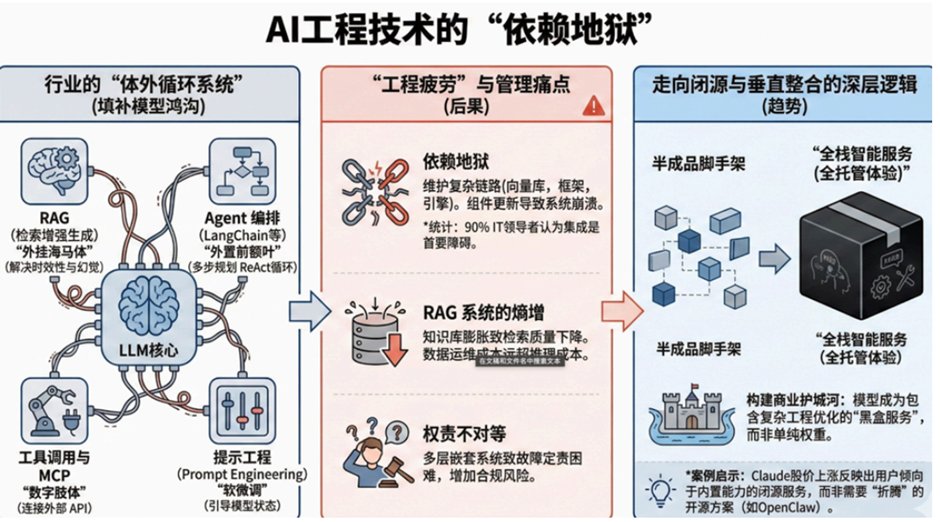
正是上述缺陷,催生了大规模的工程补偿体系——以RAG、向量数据库、编排框架等为核心的「外挂式」技术栈。
然而,随着模型能力的持续迭代,这套体系本身也暴露出新的结构性问题:
- 主流商业模型加速闭源,权重不再公开,社区难以对其进行独立测试与持续迭代验证。
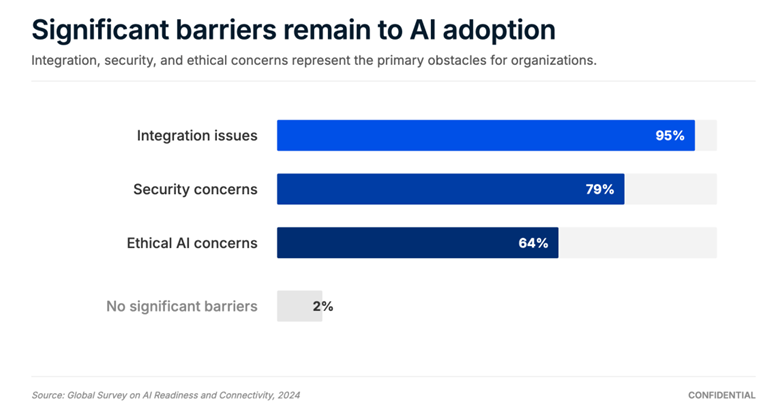
- 代码依赖带来的集成难度:企业不得不维护由向量数据库、编排框架、推理引擎等构成的复杂链路。据统计,95%的IT***将集成难度列为AI规模化落地的首要障碍。(摘自MuleSoft《Connectivity Benchmark Report》)
- 后续运营运维的技术债:知识库规模膨胀,RAG检索质量持续下降,数据清洗与运维成本甚至远超模型推理成本。多层嵌套架构使故障定责几乎不可能,合规风险随之攀升。
- 价值稀释:最终用户购买的不再是一个“智能”,而是一个需要复杂持续运维的“半成品”。工程复杂度本身成为AI价值变现的**障碍。
第二部分 国产算力平台上的全链路工程化突破
2.1 DeepSeek V4发布:算法研发、模型训练、部署推理三个领域同时取得突破
DeepSeek V4的正式发布,意义远不止于一次模型性能的迭代刷新。
它所代表的,是中国AI技术栈首次“学术论文创新”、“可运行的万亿参数训练”与“商业级稳定推理服务”三个维度上,同步完整实现,并公布了具体工程化通路。
这条通道的意义在于:此前,即便算法论文层面的创新十分耀眼,但从论文的数学公式到稳定训练并负载在自主推理硬件的生产环境,中间仍横亘着难以逾越的工程天堑。DeepSeek V4的价值,正在于它**次在国产算力平台上将这道天堑填平——让算法创新不再止步于论文,而是真正走完从数学公式到可量产、可商用的完整工程闭环。
2.2 实现「被动适配算力」到「主动定义算力」的模型研发范式变迁
在DeepSeek V4之前,国产算力平台更多扮演着“被动适配者”的角色——努力追赶CUDA生态的接口兼容性。DeepSeek V4与昇腾的协同,标志着这一模式的彻底改变。
- 硬件芯片特性赋能算法设计,充分发挥硬件架构红利:mHC(流形约束超连接)深度对齐达芬奇架构,通过将流形算法逻辑直接驻留于L1及Unified Buffer,精细化调度Cube/Vector原生缓存层级,彻底消除I/O瓶颈;MoE路由训练调度通过深度解构昇腾NPU矩阵单元特性,使N2N模式摆脱传统通信瓶颈,实现原生加速。
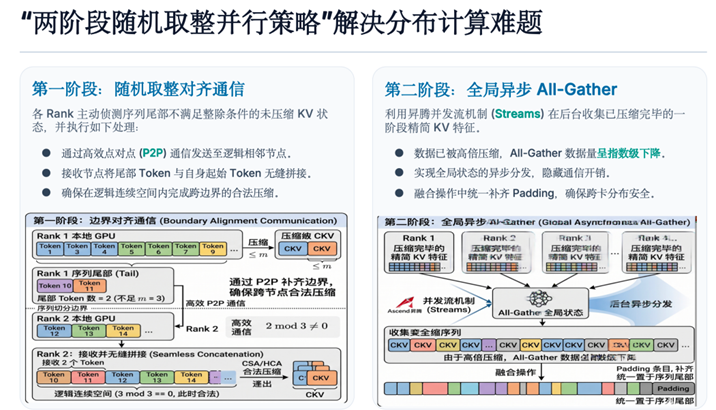
- 硬件通信框架协同算法需求:Muon优化器对全局梯度的特殊需求,催生了昇腾HCCL通信库针对梯度精度保全的专项设计;针对稀疏注意力在跨卡分布时的负载不均与通信冗余,昇腾实现两阶段上下文并行通信策略的工程落地。
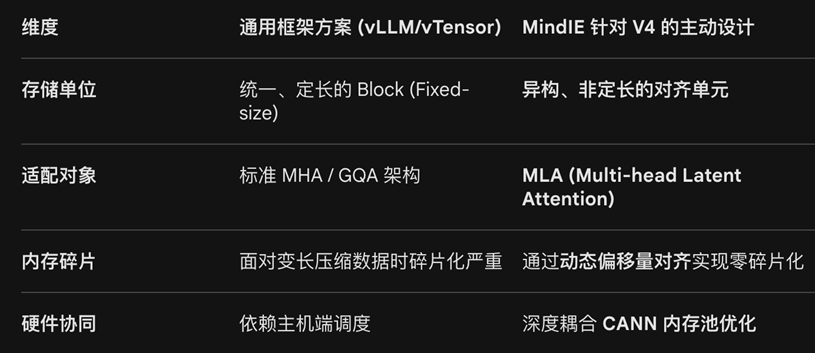
- 硬件生态服务适配模型新特性:为适配DeepSeek V4独特的KV Cache异构拓扑,MindIE升级内存管理机制,主动感知压缩维度差异,动态调整内存对齐边界,彻底消除异构数据块存储时的碎片化隐患。
第三部分 技术拆解——昇腾CANN生态在全生命周期的能力支撑
3.1 研发阶段:支持非标准算子快速开发
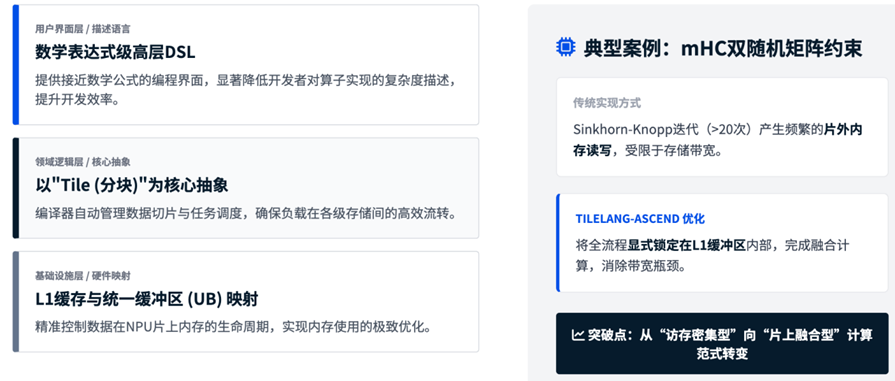
TileLang-Ascend领域特定语言:昇腾CANN生态专为学术创新设计的DSL,以“分块”为核心抽象,允许开发者用接近数学表达式的高层语言描述计算逻辑,自动将负载精确映射到昇腾NPU的L1缓存和统一缓冲区。以mHC的双随机矩阵约束为例,传统实现每次迭代产生大量片外读写,而TileLang-Ascend将整个迭代过程锁定在L1缓冲区完成融合计算,从根本上消除了带宽瓶颈。
PyPTO编程范式:以Python为统一接口,允许模型研发团队声明并行任务的依赖关系与同步点,底层自动生成高效NPU多核调度代码,将算子开发周期从数周压缩至天级。
3.2 训练阶段:利用昇腾硬件优势开发独立训练算子,实现训练目标
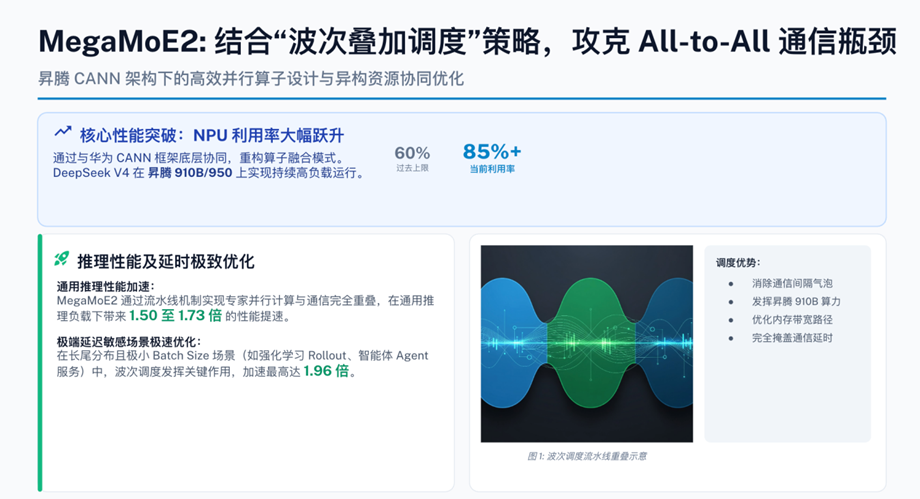
MegaMoE2融合算子与波次调度:昇腾针对DeepSeek V4升级MegaMoE2融合算子,将专家计算与All-to-All通信拆分为细粒度“波次”,在流水线层面精确交叉编排,实现计算与通信完全重叠,将训练气泡压缩至接近零。
MindSpore对Muon优化器的训练算子:Muon优化器要求在更新参数前获得跨所有设备的完整梯度矩阵,这与ZeRO参数切分策略存在冲突。昇腾MindSpore通过对Muon算子进行逻辑隔离与HCCS硬件局部加速,实现在局部空间维度还原全局数学逻辑,兼顾Muon收敛性与ZeRO扩展性。
HCCL随机取整双阶段通信机制:在执行Newton-Schulz迭代时,昇腾HCCL通信库通过**阶段随机取整将梯度量化为BF16用于跨节点传输,第二阶段在本地执行FP32高精度累加,消除舍入误差积累,保障千万步训练的位级结果一致性。
3.3 推理阶段:内置硬件推理的性能优化逻辑
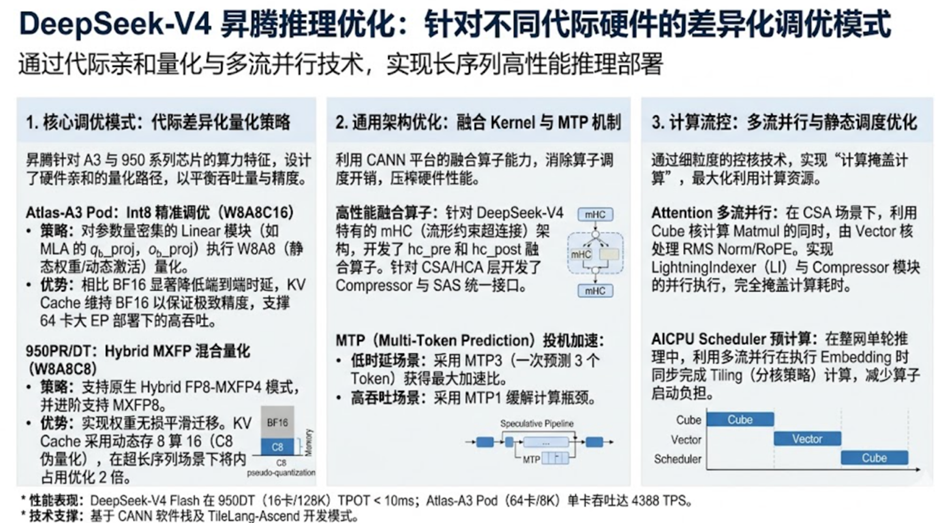
对DeepSeek模型提供独立调优策略:Atlas-A3 Pod采用Int8精准调优策略,显著降低端到端时延;950PR/DT采用Hybrid MXFP混合量化策略,实现权重无损迁移,KV Cache内存占用优化2倍。
CANN平台对mHC、CSA机制的原生支持:开发hc_pre/hc_post融合算子与MTP投机加速,针对CSA场景利用Cube/Vector核多流并行,减少计算耗时。AICPU Scheduler预计算进一步减少算子启动负担。
第四部分 场景探索——电力与财经领域Agent垂直训练破局
4.1 QKV机制:行业/领域Agent训练的必要性
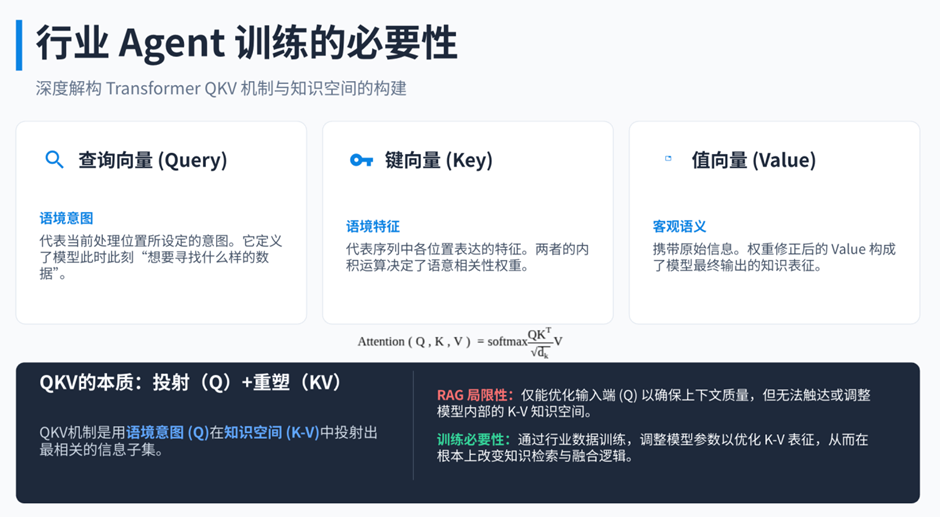
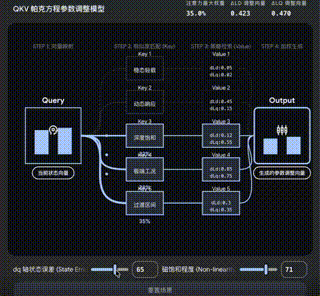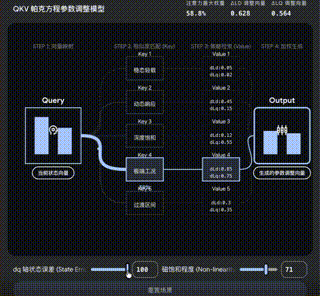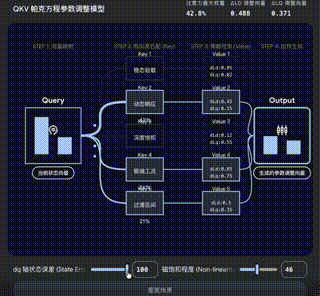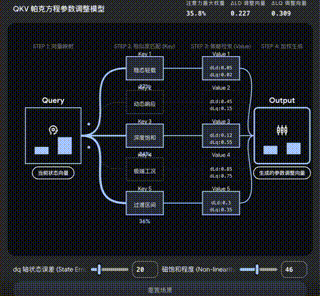
QKV机制的本质:用语境意图在知识空间中投射出最相关的信息子集。传统“知识图谱+RAG”局限于提升投射的输入质量,却无法对大模型知识空间进行调整。当电网动态调节不再适用“源随荷动”的经典假设时,就需要基于历史数据和人工调整经验的QKV学习实现智能调节。
4.2 「知识图谱+RAG」的能力边界:上下文工程无法解决的四大痛点
痛点一:领域知识漂移 —— 模型权重中根本不具备理解专业规程的基础能力。
痛点二:任务执行范式变化 —— 仅靠Few-shot无法支撑稳定高质量的输出,需要指令微调将能力内化。
痛点三:主观意图推理 —— 多学科冲突裁决需要MoE专家动态激活,沉淀跨学科推理能力。
痛点四:极精准的事实纠偏 —— 审计与电网诊断需要全量数据吞吐及全景关联诊断,RAG分块必然带来信息损失。
4.3 垂直Agent训练:破局之路
- 针对领域知识漂移:企业私有专业文档持续预训练,将专业语义能力固化入权重。
- 针对任务范式变化:高质量指令有监督微调+同策略蒸馏,培养专项路由专家。
- 针对主观意图推理:MoE专家分化+领域强化学习,昇腾分波次调度实现专家低延迟激活。
- 针对事实纠偏:昇腾超节点NAND SSD磁盘驻留KV Cache,实现企业海量原始数据全量直接吞入与全景关联诊断,绕过RAG信息损失。
第五部分 未来趋势总结——基础设施创新与多模态、具身智能展望
趋势一 算力基础设施的细分创新
研发阶段关注非标准算子快速开发与灵活性;训练阶段关注万亿参数模型的**通信重叠与MFU;推理阶段关注高并发Agent工具调用、TTFT与TPS。市场算力生态将沿此三维度细分创新,国产算力迎来差异化竞争机遇。
| 细分阶段 | 核心能力需求与创新方向 |
|---|---|
| 研发(试验与学术) | 重点支持非标准算子的快速开发(TileLang-Ascend DSL)与学术验证。核心指标是算子开发效率与底层灵活性。 |
| 训练(发布可运行模型) | 重点实现万亿参数模型的**通信重叠与分布式精度保全。核心指标是MFU与训练稳定性。 |
| 推理(商业Agent服务) | 重点支持高并发Agent工具调用与双内核解码的批次不变性。核心指标是TTFT、TPS与结果一致性。 |
趋势二 Decoder架构下的多模态基础设施演进
DeepSeek V4在多模态领域的相对保守受工程制约。未来需解决:图像Token的稀疏注意力优化、视频流的时序压缩与KV Cache管理、音频低延迟实时处理。当国产算力底层形成成熟多模态支撑方案,语言为核心枢纽的原生多模态Decoder将成为下一代基础模型标准形态。
趋势三 具身智能的泛化性突破
当前具身智能局限于行为克隆,DeepSeek V4所代表的“内化”路线提供新路径:物理世界知识的权重内化使机器人具备先验推理;大模型深层逻辑推理赋能决策;世界模型的预测-行动闭环实现强化学习与大模型深度融合。
DeepSeek V4与昇腾CANN的协同,标志着中国AI技术栈正在从依赖既有CUDA生态的“追赶者”,转变为能够主动定义算法-算力协同架构的“规则制定者”。
这场跃迁将AI能力的竞争维度,从单纯的算力规模竞赛,引向了算法设计到软硬协同的生态比拼。
行业企业需要建立从模型研发训练到Agent应用部署全栈的自主能力,实现试验—训练—推理全链路可控,是本轮AI数智化转型的核心应对路径。



