
公告
**批 GEO 赢家出现了, 他们做对了什么?
五条做好GEO的成功经验 · 场景、问题、产品依据、解释权、第三方共识
2026-09-25 01:00
📌 梁将军 · 36氪
**批 GEO 赢家出现了, 他们做对了什么?
五条做好GEO的成功经验 · 场景、问题、产品依据、解释权、第三方共识
🔑 核心关键词:GEO, 生成式引擎优化, AI搜索, 场景营销, 产品依据, 解释权, 第三方共识, 结构化内容, Knix, Freshpet, 品牌可见度
📄 文章详情描述:2026年AI搜索重塑品牌推荐逻辑。H&M、优衣库输给加拿大小品牌Knix;可口可乐靠场景资产被AI优先推荐;DiscoverASR重写房源页后AI搜索人数翻近5倍;Freshpet通过解答具体喂养问题在Google AI摘要中增长645%。本文拆解GEO五大关键:抢场景、抢问题、抢产品依据、抢解释权、抢第三方共识。
📝 文章摘要:GEO让品牌竞争从“消费者先想起谁”变为“用户提出具体问题时AI推荐谁”。Knix凭借产后、漏尿等长尾问题被AI高频推荐;可口可乐因场景资产占优;DiscoverASR用场景化改写让AI引用翻倍;Freshpet靠喂食指南被AI引用。核心动作:场景拆解、问题挖掘、参数结构化、官网事实更新、社交证据链。最后警示:品牌**危机是被AI误读,评论区比通稿更影响AI判断。
GEO 赢家思维导图 · 五维抢位
01 抢场景
02 抢问题
03 抢产品依据
04 抢解释权
05 抢第三方共识
GEO
赢家
赢家
成为“有面包车的朋友”
回答具体麻烦
参数可比较
官网+社交时间线
记者·专家·消费者互证
01 抢场景:先成为那个时刻里的合适人选
H&M、优衣库、维多利亚的秘密,输给了一个加拿大小品牌。2026年8月,AI搜索专业媒体Search Engine Land向ChatGPT和Google AI Mode提了20组购买问题,比如:“产后身材适合穿什么内衣?”、“经期内裤有哪些值得推荐?”结果,H&M、Uniqlo和Victoria’s Secret总共只出现了2次。一个加拿大小品牌,叫Knix,出现了整整29次!
如果用户问“有哪些知名内衣品牌?”H&M、Uniqlo这些大品牌当然占优,但用户一般不这么问AI啊!用户会问的是:吸收量怎么样,漏尿怎么办,产后身体如何选择……这些问题正中Knix这个小品牌的下怀,因为它的官网、商品页、媒体报道和用户评价,一直都在讲这些。于是,一个过去名不经传的小品牌,突然被AI老师安排到了前排。
这可能是GEO带来的**变化:过去,品牌争的是消费者先想起谁。现在,用户提出某个具体问题时,AI愿意推荐谁。而且,用户每换一个问题,AI都可能重新排一次座。
最近,我和团队研究了一堆GEO案例,大部分是海外的做法。我发现,虽然它们表面上做法不同,实际都在抢五个东西:场景、问题、产品依据、解释权和第三方共识。
假设你和女朋友去看电影,爆米花已经买好了。选饮料时,她说:“随便。”恋爱经验告诉我们,“随便”通常不是都行的意思,而是在考验你对她的用心程度。于是,你偷偷问AI:“看电影配什么饮料?”AI大概率会让你买可口可乐。2026年7月,AI品牌研究机构LLM Brand Positioning追踪了13个饮料品牌。在“看电影配什么饮料”中,它的品牌领先率达到了100%!
讽刺的是,可口可乐没有公开宣布实施过GEO,它营销电影、汉堡和观赛场景的时候,今天的AI研究员可能都还没有出生。也就是说,是几十年的广告、餐厅菜单和消费者分享,把可乐深深植入到了这些场景里。于是,过去的场景资产,今天成了AI的理解线索。这不意味着品牌只要批量发布几十篇“××十大使用场景”,AI就会照单全收。
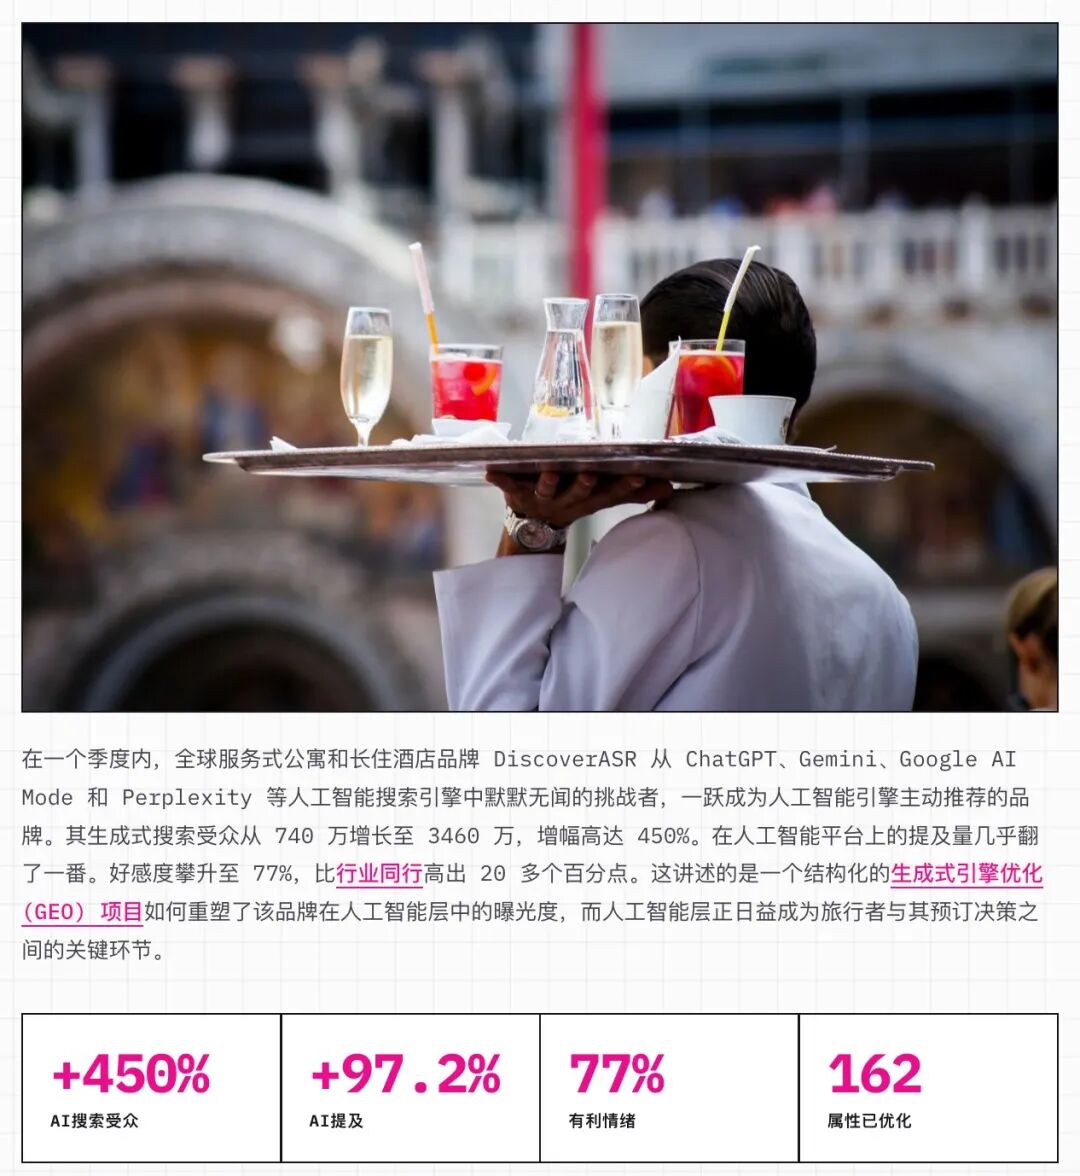
比如,一家三口准备在东京住一个月,问AI:“有哪些适合家庭长住的公寓?”AI真正要处理的是一串问题:能不能做饭,洗衣服方不方便,附近有没有超市,孩子住起来是否合适,连续住一个月会不会太贵。海外有个酒店公寓品牌,叫DiscoverASR,拥有很多房源。但页面上大多都是“舒适体验”“优越位置”“设施完善”等这些抽象的表述。AI知道它很好,却说不清它适合谁。后来,团队收集了21类真实旅行问题,重写了162个房源页。他们把“设施完善”被拆成有厨房、能洗衣,把“适合长住”融入到场景里,说清楚适合家庭、商务出差还是数字游民。一个季度后,DiscoverASR的AI搜索人数从740万升到了3460万,有4300个自有页面被AI引用。
我们平时选择别人,其实也是同样的逻辑。搬家当天,你不会把通讯录里的朋友按照学历、收入和幽默感逐项打分。你会首先想到那个有面包车的人。他可能三年没给你点过赞,但在搬家这道题里,他就是最合适的答案。品牌经营场景,本质上就是把自己变成那个“有面包车的朋友”。当人物、地点、任务和限制等条件同时出现时,AI才有理由把你放进候选名单。
02 抢问题:被想到以后,还要说清楚为什么选你
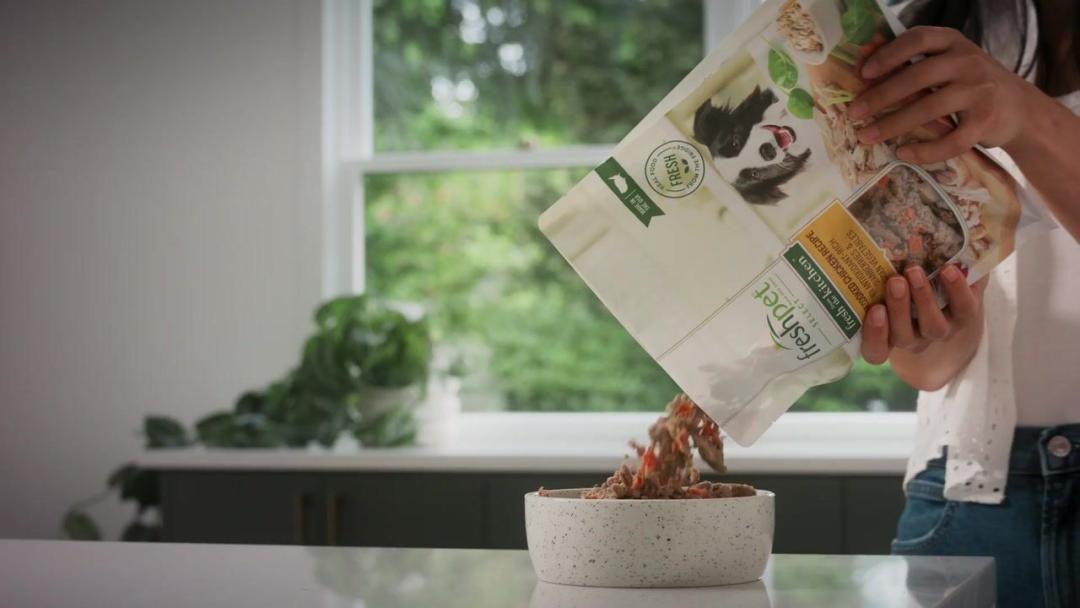
场景只能让品牌进入候选名单。最终能不能被推荐,要看它是否真正回答了用户眼前的麻烦。宠物鲜食品牌Freshpet,很早就在做这件事。宠物鲜食刚兴起时,大部分品牌都在讲“新鲜、天然、健康”。这些词没有错,但消费者买回家以后,遇到的是非常具体的问题:
- 不同体重应该喂多少?
- **次换粮怎么过渡?
- 狗吃完肠胃不适怎么办?
- 鲜食打开后能保存多久?
于是,Freshpet针对这些购买问题做GEO,让相关信息更容易被搜索和引用。做了6个月后,Freshpet在Google AI摘要中的出现量增长645%,AI带来的访问也增长46%。
它做的事情看起来并不神秘,就是教人怎么喂狗。区别在于,这些过去散落的信息,终于被整理成AI能够找到和使用的答案。我们开篇提到的Knix也是一样。“产后恢复”让它进入候选名单,但是吸收量、漏尿、尺码和清洗方式,才让AI有理由推荐它。
我觉得,GEO给很多垂类小品牌提供了机会。虽然大品牌可以凭知名度赢得大类,但在具体的问题上,谁回答得更完整,谁就能弯道超车。但对品牌而言,最难的不是给出专业答案,最难的是找到对的问题。因为你得先知道消费者在苦恼什么?才能给出答案啊。
我的经验是,可以先到社交平台上观察。微博适合看公开讨论和突发话题,小红书更容易暴露具体使用体验里的麻烦,B站的测评和评论常常集中在性能与细节,知乎则会把一个问题展开讨论。平台不同,用户表达苦恼的方式也不同。比如,我们不会说“我的宠物存在肠胃健康需求”,只会说:“我家狗换粮以后一直拉肚子,该怎么办?”品牌真正要找的,是这些反复出现的抱怨、追问和犹豫:消费者卡在哪里,现有答案又漏掉了什么。问题找准了,专业内容才知道该回答什么。而且这些自然表达,也最接近人们向AI提问时使用的语言。大家把这些问题,整理成产品解释、使用指南和专家答疑,品牌就有机会被AI引用。
03 抢产品依据:品牌得提供比较依据,AI才能做出选择
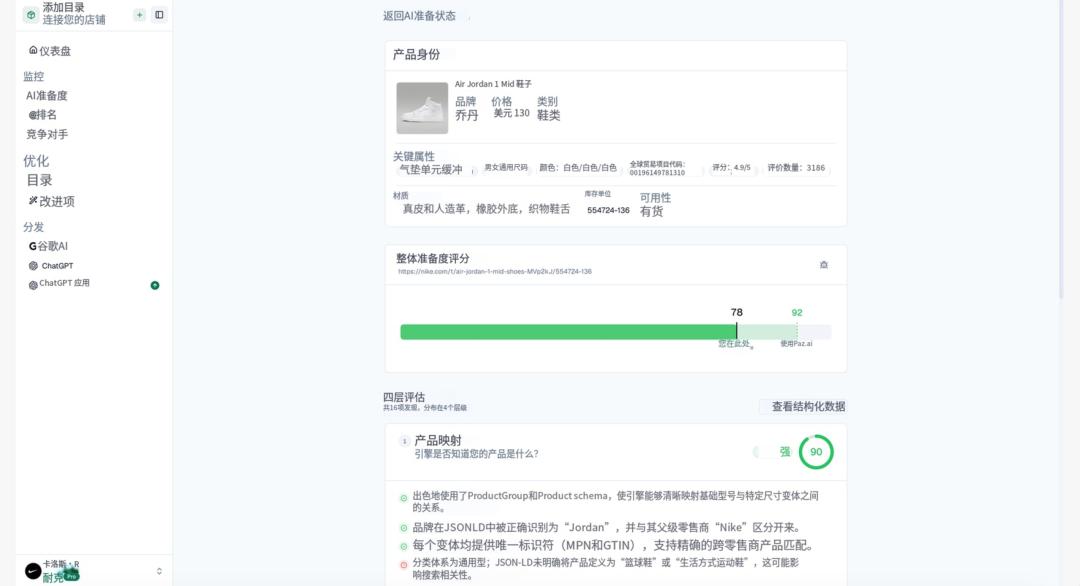
2026年,AI购物监测机构Paz.ai给50个鞋类品牌安排了一场“匿名考试”。测试问题全部隐去品牌名,只保留购买条件:“推荐一双150美元以内、有气垫的跑鞋。”“哪双篮球鞋也适合日常穿?”等等。每一个购物搜索查询里,耐克都出现了。我们很容易把这事解释成“耐克知名度高”,但研究人员公开产品信息后,大家会发现,耐克赢得非常“具体”。
以Air Jordan 1 Mid为例,商品页写清颜色、尺寸、材质、售价和库存,还有3186条评价、4.5星评分等等。AI判断预算、材质和库存时,答案都摆在页面上。这揭示了AI购物的一条规则:产品想被推荐,首先要能够被比较。
如果三个品牌都告诉AI“我们品质**”,就像三位求职者都在简历上写“工作认真、综合能力强”。态度都很好,但招聘经理还是不知道该选谁。很多品牌做不好GEO的问题,就是因为卡在这啦:AI需要的是判断依据,品牌递过去的却只有态度。这时候谁能把优势说得更具体,谁就更容易被AI选中。
3C和家电品牌在这件事上有天然优势。芯片、续航、重量、尺寸、像素、功率、能耗,本身就是可以直接比较的条件。用户问“预算3000元,想要一部续航久、重量轻的手机”,AI可以迅速做出选择。小米就经常在微博上直接“show肌肉”,把散热系统、散热面积这类细节公开出来。参数一旦摆进开放的讨论场,网友自然会在评论区和话题中横向比较。同价位产品放在一起,小米这一栏有明确数字,没有公开数据的品牌只能显示“未知”。
在人类传播中,留白有时意味着高级;在AI的比较表里,“未知”通常只意味着缺少判断依据。少写一个参数,失去的可能是一次进入比较的机会。
很多消费品牌的优势住在“更高级”“更舒适”“匠心品质”里。人能配合画面感受,AI拿来比较就很为难。美妆行业这方面就做得相对好一些。“年轻”“逆龄”“高级”都属于感受,但是他们同时会告诉消费者,针对什么肌肤问题、通过什么机制发挥作用、哪些功效是通过视黄醇、烟酰胺这些成分来实现的。简单说,抢产品依据就是要把“我很好”,翻译成AI可以直接引用的、结构化的答案。
04 抢解释权:不要总让别人介绍自己
AI学会比较以后,还会遇到另一个问题:网上关于同一个品牌有很多种说法,到底哪一种可信?这很像参加同学聚会。你还没来得及开口,老同学已经介绍完了:“他好像在做互联网,应该还没结婚。”最后发现,整段介绍里只有名字是准确的。印尼野生动物园Taman Safari也遇到过类似问题。他的票价、开放时间等关键信息都来自外部平台,其中一部分信息还过时了,平台也没有更新。
于是,这家动物园团队重新整理了官网,把门票、开放时间、园区区别和游览方式,都写成可以直接引用的答案,同时统一外部平台上的名称、地址和基础信息。十周后,他们的官网引用率由12%升至38%,ChatGPT品牌提及率由15%升至48%。
品牌的解释权,不是把“专业领先”“值得信赖”重复更多遍。AI只是需要的能够核对的基本事实:价格、时间、规则、使用方法、服务范围,以及这些信息是否仍然有效。
官网适合保存稳定信息,但新品发布、产品调整、政策变化和争议回应,往往发生得更快。等官网完成一轮修改,网友可能已经替品牌写完了大结局。这时候,品牌需要在微博、小红书这类社交媒体上,记录品牌正在发生什么。因为每条信息都带着公开身份、发布时间和事件背景,能够沿着时间线被继续核对。
同样一句“产品已经召回”,由品牌官方今天发布,和网友三年前转述,显然不是同一种信息。AI处理品牌近况时,也必须先分清两件事:是谁说的,什么时候说的。比如,一家汽车品牌刚刚调整了某款车的辅助驾驶功能,官网还没来得及更新,消息已经在社交平台上跑了几圈:微博上有人说“功能被砍了”,B站有博主逐帧分析发布会,小红书车主开始担心老车型也会受到影响。这时候,品牌最重要的不是追着每条评论解释,而是尽快留下可以核对的信息。比如先由官方微博说明到底改了什么、什么时候开始、影响哪些车型,再在官网或公众号放出完整规则,有必要的话补一段演示视频。这样,无论消费者还是AI,都能顺着公开的时间线找到原始信息,而不是拿几条转述拼答案。
如果说官网像户口本,负责说明“我是谁”,社交平台更像现场记录,补充“我刚刚做了什么”。两类信息都清楚,AI才不会用三年前的答案回答今天的问题。
05 抢第三方共识:品牌说清楚自己后,AI会向外核实
GEO里有一个常见误区:只要把同一篇稿子铺到足够多的网站上,就能让AI相信,很多人都在认可这个品牌。周二下午三点,一家小家电公司的新品发布会结束。市场经理回到后台,把《新品重磅发布,引领行业升级》的通稿发进媒体群。四点十分,老板在工作群里问:“出了多少篇?”市场经理数了数:“四十六篇。”点开其中三篇,标题一样、正文一样,连第二段的逗号都没有移动。看起来有四十六家媒体在说话,实际只是同一篇稿子,换了四十六个网址。
这种方式能制造声量,却很难形成共识。就像十个人都说你长得帅,后来发现都是你妈拉进群的,只能证明家属意见比较统一。AI也不会简单地把四十六个网址内容,当成四十六张独立选票。它会判断:这些内容是否彼此独立,背后有没有不同的证据?
媒体提供采访和调查,专家给出专业分析,消费者分享实际体验。不同身份的人从不同角度出发,最终得出能够互相印证的判断,才更接近真正的第三方共识。某个全球健康教育品牌就曾经卡在这里。它官网日常会产出大量专业内容,家底看起来很厚,但最近的AI引用率却很差。团队检查以后认为,是因为最近的外部报道太少了。品牌过去获得过不少认可,AI却更关心最近还有没有媒体在报道、专家在引用、行业在讨论。
共识从来不要求所有人重复同一句广告语。记者讲调查结论,专家讲专业依据,消费者讲真实体验。几种说法能够互相对上,AI才更有理由相信:这不只是品牌对自己的评价,外界也形成了相对稳定的判断。
那么,这些共识又怎样被AI找到?AI没办法挨家挨户询问消费者,只能寻找人们公开留下的证据。比如,一个母婴品牌推出了一款儿童安全座椅。品牌先在微博公布碰撞测试结果和适用年龄,媒体随后采访产品工程师,儿童安全专家解释不同固定方式的区别,母婴博主则展示真实的安装和乘坐过程。评论区里,家长们还会继续追问:“孩子睡着后会不会歪头?”“不同身高应该怎么调节?”遇到这些具体问题,品牌客服或产品团队也可以接着回应。
这些人说的并不是同一句话。品牌提供测试结果,专家解释背后的原理,博主展示实际使用过程,消费者提出真实问题。但这些信息能够互相对上,也能顺着转发、评论和话题找到出处。这样,从品牌发布、媒体采访、专家解读、第三方体验,到消费者追问和品牌回应,一条相对完整的证据链就在公开讨论中形成了。一条微博当然不会自动获得AI信任。真正有价值的是,它会带着公开身份、发布时间和原始资料,还能看见谁引用了它、谁补充了证据、谁提出了不同意见。所以品牌经营微博也好,小红书也好,都不能只停留在发海报和搞抽奖上。要主动发布新品信息,即时回复用户消息,有专家或大V评价了自家产品,不管正面还是负面,都要正面回应……因为这些都是会AI抓取的资料,最终变成所有人的共识。
结语:品牌**的危机不是没流量,而是被AI误读
最后,讲个真实发生的笑话。某公司花了几十万做GEO,但当这个老板问AI:“这个品牌靠谱吗”,AI回答:“千万别买”。老板立刻召集市场部:“我们花这么多钱,AI为啥不看我们的内容?”市场部说:“它看了。”“看了为啥还这么回答?”“可能是因为,它也看了评论区。”
未来,品牌**的危机不是没流量,而是被AI误读。
本文来自微信公众号“梁将军”(ID:liangjiangjunisme),作者:梁将军,36氪经授权发布。
本文来源网络原创/转载文章,该文观点仅代表作者本人,不代表本站立场。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。 如若内容造成侵权/违法违规/事实不符,请将相关资料发送至honghebusiness@foxmail.com进行投诉反馈,一经查实,立即处理!本站链接 https://www.honghebusiness.com/news-industry/6014.html
昵称:
内容:
验证码: 
提交评论
评论一下



💬 评论区 · 10条